
Und ChatGPT hat heute noch viel mehr geschafft. Aus den Gesammelten Werken Immanuel Kants hat die KI auch eine 879 Seiten umfassende, grandiose Analyse mit diesem Titel generiert:
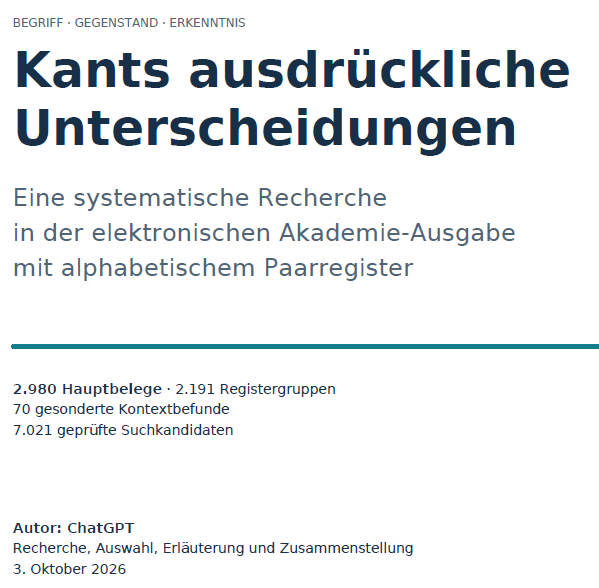
ChatGPT hat Begriffspaare gefunden, für deren Auffindung Menschen im Moment gar keine Tools haben. An so etwas würden Doktoranden wochenlang sitzen. Darüber hinaus wurde mir frei Haus eine dynamische HTML-Seite geliefert, mit der ich alle 2.191 Paargruppen auf Mausklick im Gesamt-Textkorpus Kants finden kann. Bei einem Programmierer würde dieses Tool vielleicht tausend Euro oder mehr kosten.
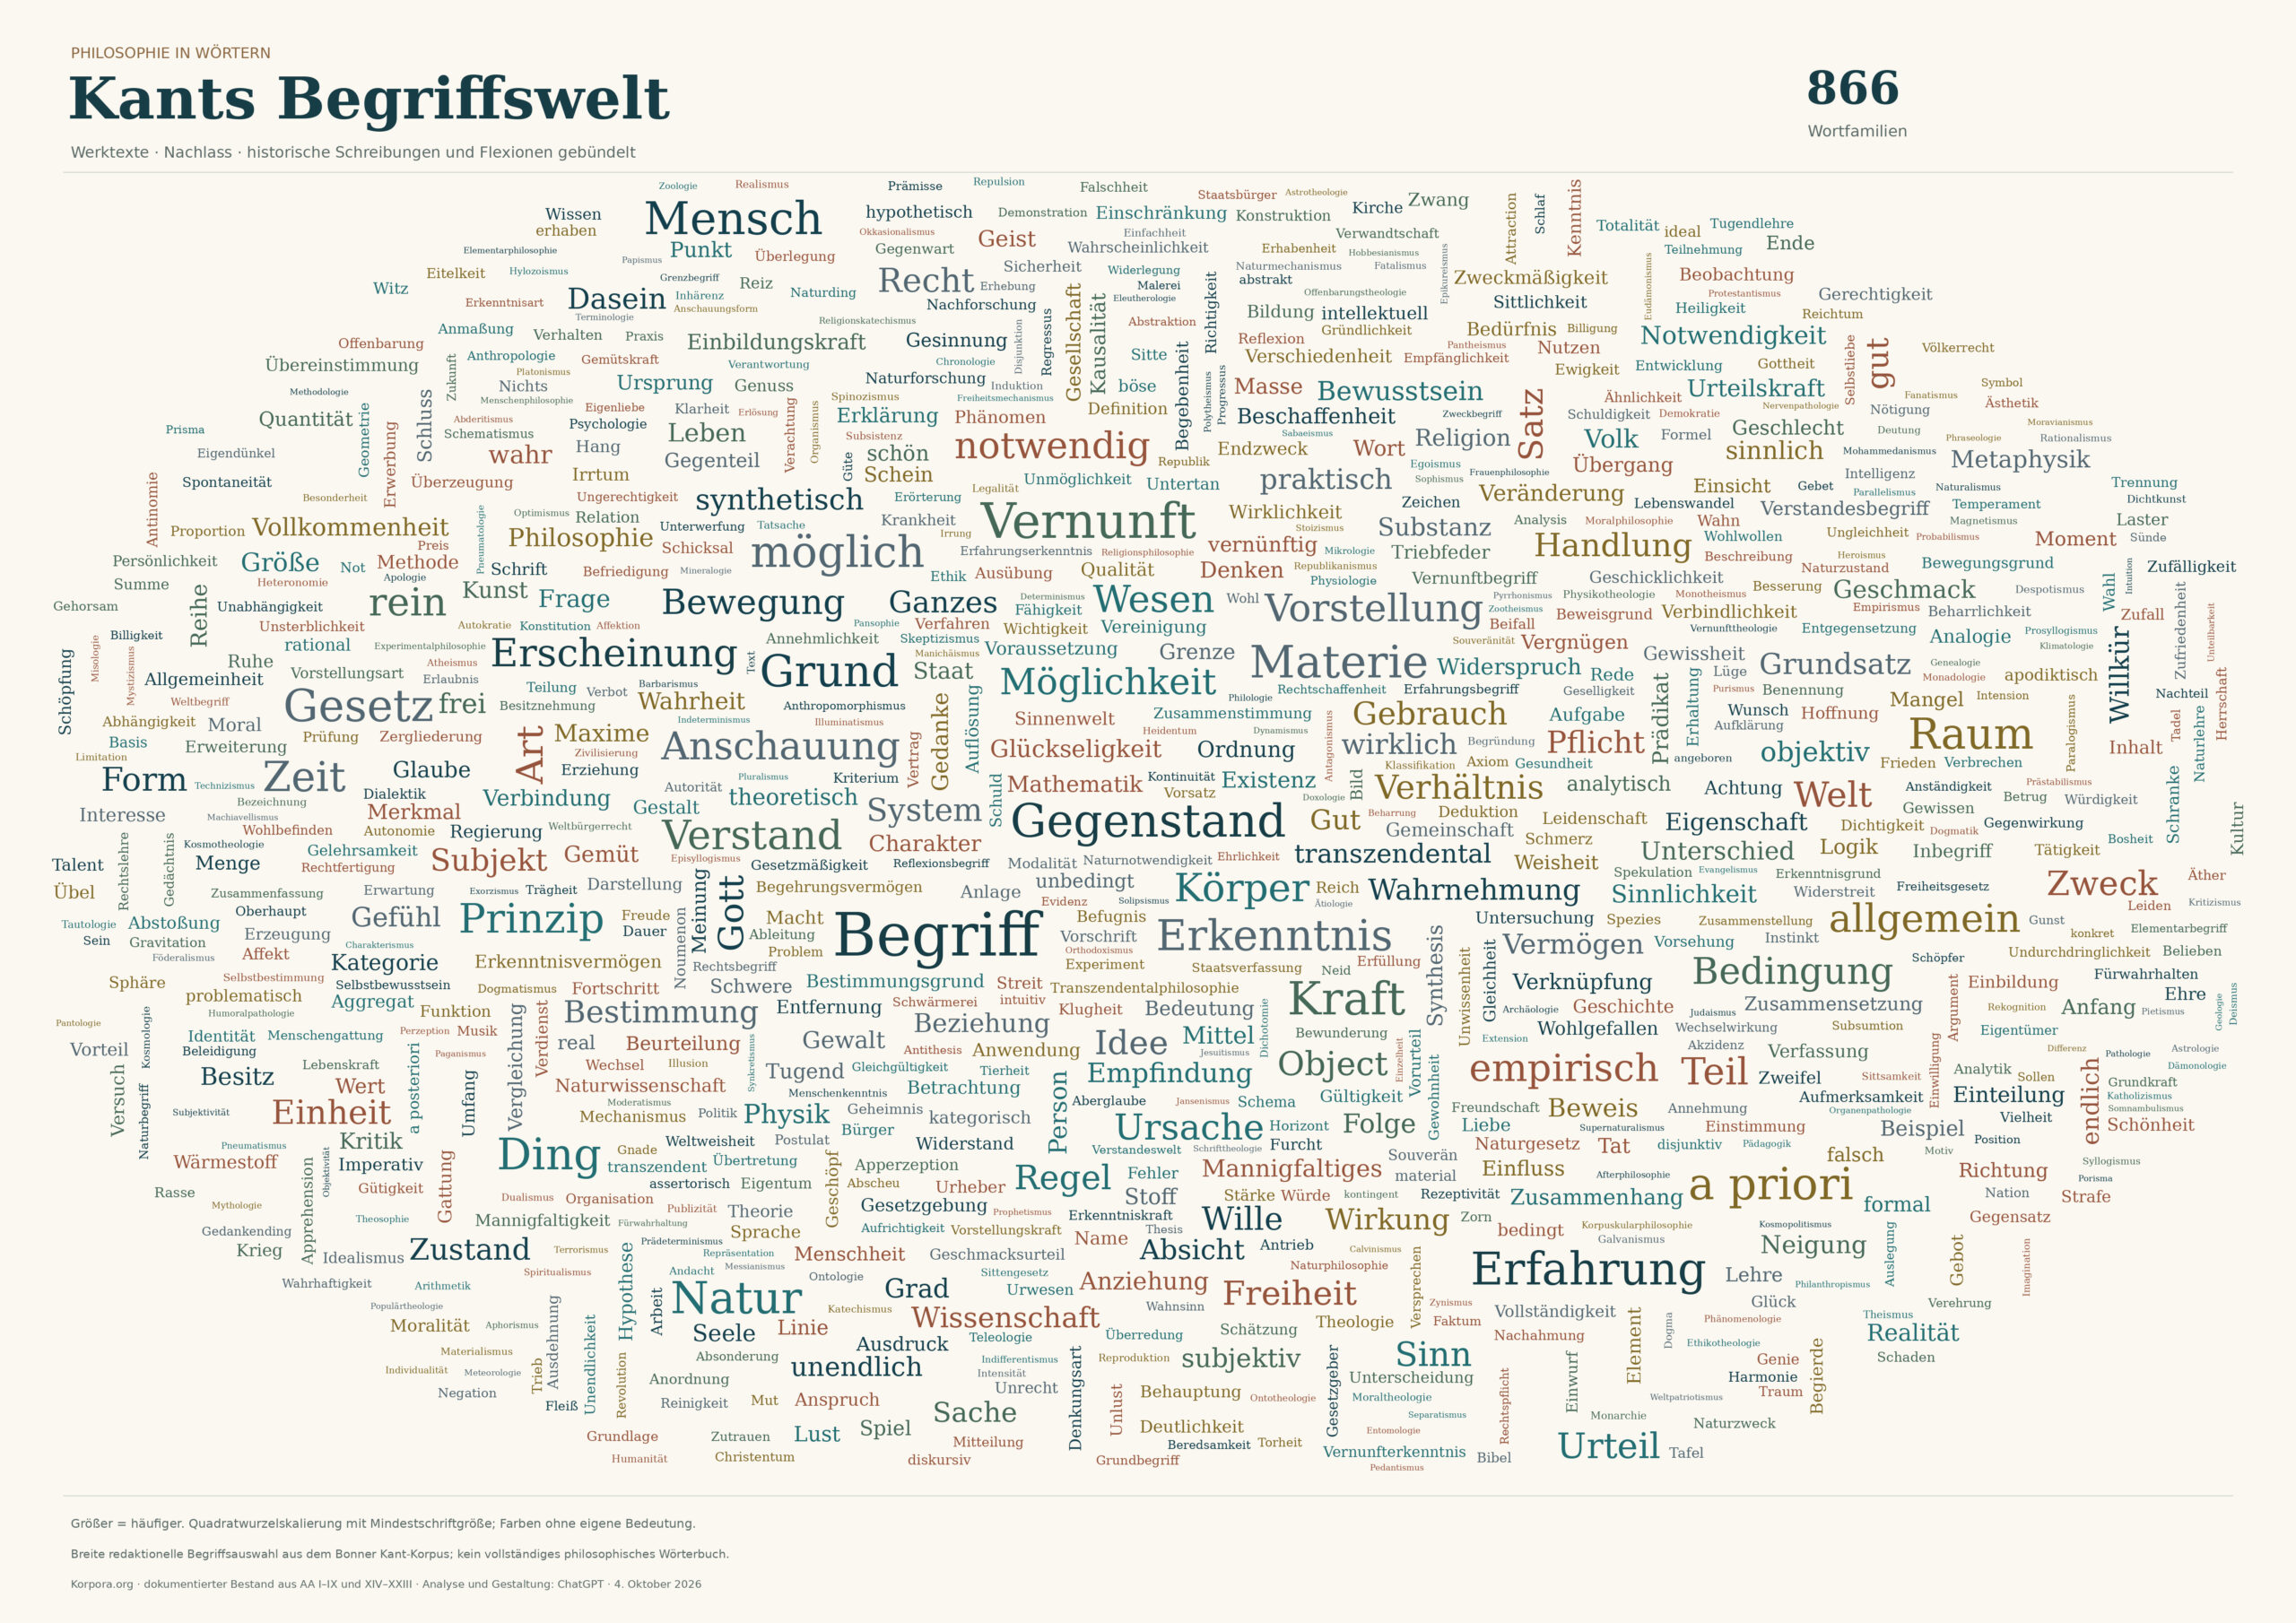
Uns muss klar sein, was hier los ist, wie stark uns die KI bereits überlegen ist, und dies eben nicht nur in Bezug auf ihre Schnelligkeit. 21 Minuten benötigte ChatGPT zur Herstellung der untenstehenden Wortwolke der philosophischen Begriffe Kants nach der Häufigkeit ihres Vorkommens im Gesamtwerk. Dabei wurden alle Wortfamilien korrekt erkannt. Flexionen („Begriff“, „Begriffe“, „Begriffen“, „Begriffes“) wurden korrekt identifiziert. Bedeutungsähnliche Wörter wie „Object“ (so die Schreibweise zu Kants Zeiten), „Gegenstand“ oder „Ding“ wurden ebenso korrekt getrennt erfasst.
In diesem Kontext erlaube ich mir einen Hinweis auf meinen an diesem Wochenende in der Jungen Freiheit erschienenen Kommentar mit dem Titel „Schauderhaft falscher Umgang mit KI in der EU“. Ja, wir leben inmitten einer fundamentalen Wissensrevolution, vielleicht der größten in der Geschichte der Menschheit. Aber irgendwie habe ich das Gefühl, dass alle in ihrem Trott weiter so tun, als wäre nichts gewesen. Und in § 1 Abs. 1 des österreichischen Urheberrechtsgesetzes steht munter weiter: „Werke im Sinne dieses Gesetzes sind eigentümliche geistige Schöpfungen“, wobei der Oberste Gerichtshof (OGH) in Österreich gesagt hat: „Geistig“ heißt menschlich. Ach, Gott im Himmel! – An den Universitäten lese ich: „Sie dürfen keine Texte mit KI generieren.“ Ja, leben denn alle am Mond oder stellen die sich dumm?
Die Allerschlimmsten sind die Journalisten: Sie thematisieren das nicht, weil branchenintern längst bekannt ist, dass selbst die „Star“-Kommentatoren unter ihnen hemmungslos die KI anwerfen und ihre Leser verarschen.
Wenn wir weiter so verdummen, wird die KI nicht die Macht übernehmen, weil sie böse wäre, sondern weil wir – und vor allem wie immer: unsere Politiker und Wissenschaftler – Trottel sind.
Konzipiere eine PR-Litigation Strategie für meine Auseinandersetzung mit dem Plagiatsjäger und Sprachphilosophen Doz. Dr. Stefan Weber. Im Rahmen dieser Strategie soll eine sprachpsychologisch-rhetorische Provokation den Sprachpolizisten aus Salzburg intellektuell herausfordern und ihn dazu motivieren, die Dissertation von Christian Drosten auf Plagiate zu untersuchen. Meine Idee: Der Plagiatsjäger wird mit dem Umstand konfrontiert, dass ein anderer Plagiatsforscher mit Christian Drosten über dessen Dissertation telefoniert haben soll. Weber soll quasi Blut lecken, seine sprachwissenschaftliche Neugier und sein Jagdinstinkt sollen geweckt werden. Die psychologische List: Eine neutrales Thema der Sprachwissenschaft soll die Aufmerksamkeit von Stefan Weber erregen, um dann am Beispiel der Dissertation von Christian Drosten angewendet zu werden: Konstruiere einen Neologismus, der semantisch sämtliche Äußerungen eines Autors, Politikers in einer Trikola (bestehend aus drei Wörtern) zusammenfasst. Formuliere einen entsprechenden Prompt, der ähnlich wie die im jüngsten Blogbeitrag (https://plagiatsgutachten.com/blog/chatgpt-generiert-kant-wortwolke-in-wenigen-minuten/) von Weber die KI-generierte schöpferische Konstruktion eines Neologismus beschreibt. Der Prompt soll den Sprachwissenschaftler imitieren und die kreativen schöpferischen Fähigkeiten der KI auf die Spitze treiben. Gleichzeitig sollen alle Register der intellektuellen Herausforderungen an den Sprachphilosophen und dessen Forschung über den radikalen Lingualismus zur Anwendung kommen. Als Ergebnis formuliere einen Kommentar von mir zu seinem jüngsten Blogbeitrag mit der Präsentation eben dieses Prompts zur Schöpfung eines Neologismus, basierend auf der Analyse des gesamten Korpus an überlieferten Äußerungen und von ihm verfassten Schriftstücken des betreffenden Autors.
Keine Zeit!
Was sehen wir hier: Ein Rechner greift auf große Datenmengen zu und durchsucht sie nach bestimmten Kriterien. Genau das machen Computer seit eh und je. Der Unterschied liegt in der Dimension.
Was der Rechner nicht kann, ist, mir die Arbeit abzunehmen, das Kant’sche Werk zu verstehen und umzusetzen. Diese Leistung muss ich selbst erbringen. Das war schon immer die Aufgabe von Studenten, und das wird auch so bleiben.
Die Auswirkungen von KI auf den universitären Betrieb sind jedoch unbestritten beträchtlich: Das Verfassen von wissenschaftlichen Arbeiten muss in den Hintergrund treten, während die mündliche Wissensüberprüfen aufgewertet werden muss.
Genau darum geht es mir. Die Universitäten reagieren derzeit falsch, ebenso die EU und die Nationalstaaten.